Sur un site web, certaines pages ne doivent pas apparaître dans les résultats des moteurs de recherche, malgré leur accessibilité en ligne. C’est précisément le rôle de la balise noindex, une directive SEO essentielle pour contrôler l’indexation. Comprendre ce mécanisme, ses usages et surtout comment le vérifier techniquement reste indispensable pour ne pas compromettre votre visibilité. Deux méthodes techniques permettent de poser cette directive — la balise meta robots dans le HTML, ou l’en-tête HTTP X-Robots-Tag pour les ressources non-HTML — et une seule condition suffit à les rendre inopérantes toutes les deux : que la page soit bloquée par le fichier robots.txt avant que le robot ait pu lire la directive.
L’essentiel
- La balise noindex empêche l’indexation tout en autorisant le crawl, contrairement à robots.txt ou disallow qui bloquent l’accès aux robots.
- Ne jamais combiner noindex et disallow sur la même page : bloquer l’accès au crawler empêche justement la lecture de la directive noindex.
- Utile sur les pages fines, les doublons non gérés par canonical, les environnements de staging et les pages administratives.
AFFICHER LE SOMMAIRE
Qu’est-ce que la balise noindex ?
Définition et rôle de la balise noindex
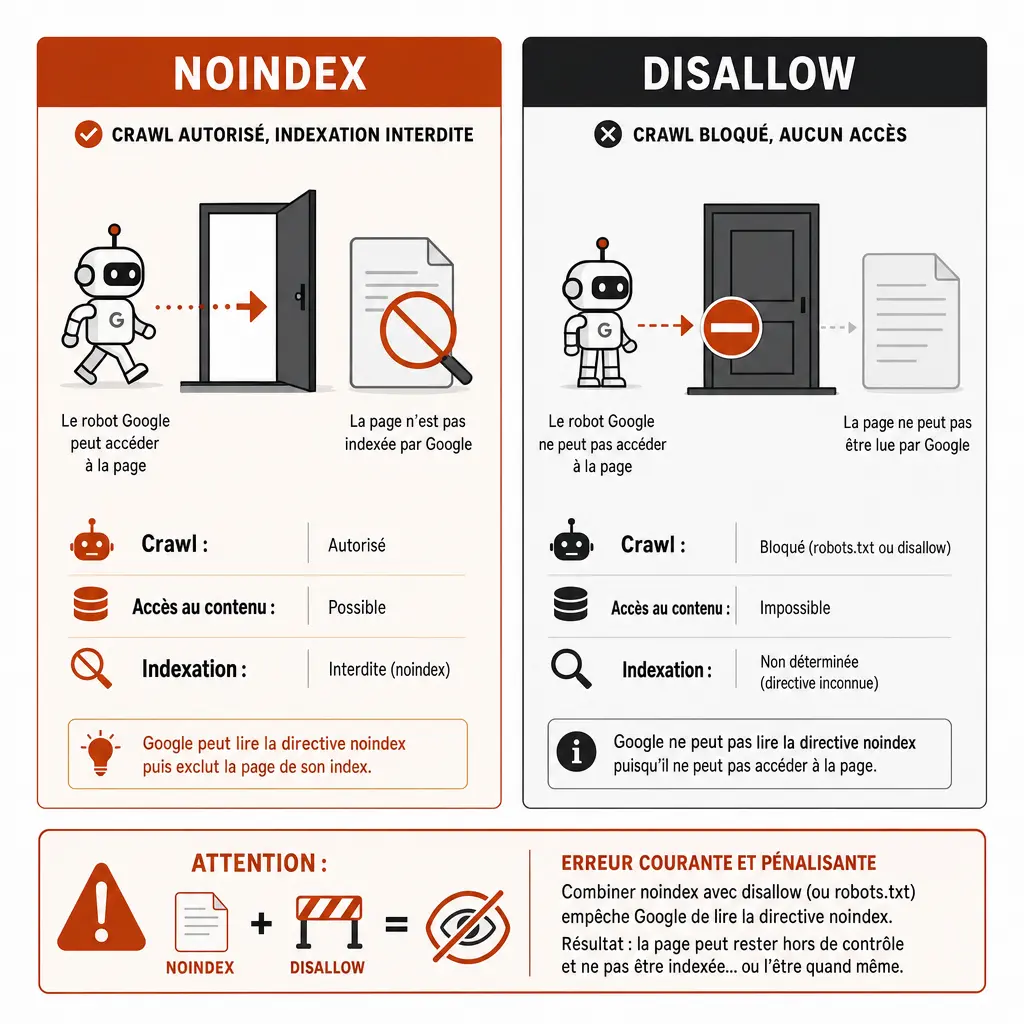
La balise noindex est une directive SEO qui empêche une page web d’être indexée par les moteurs de recherche, comme le documente la documentation officielle de Google Search Central. Elle indique aux bots qu’il ne faut pas afficher cette page dans les résultats, tout en autorisant son exploration. Cette nuance change tout : elle permet au crawler de parcourir la page et de transmettre son jus SEO via les liens qu’elle contient, sans la référencer.
Méthodes d’implémentation : balise meta et header HTTP
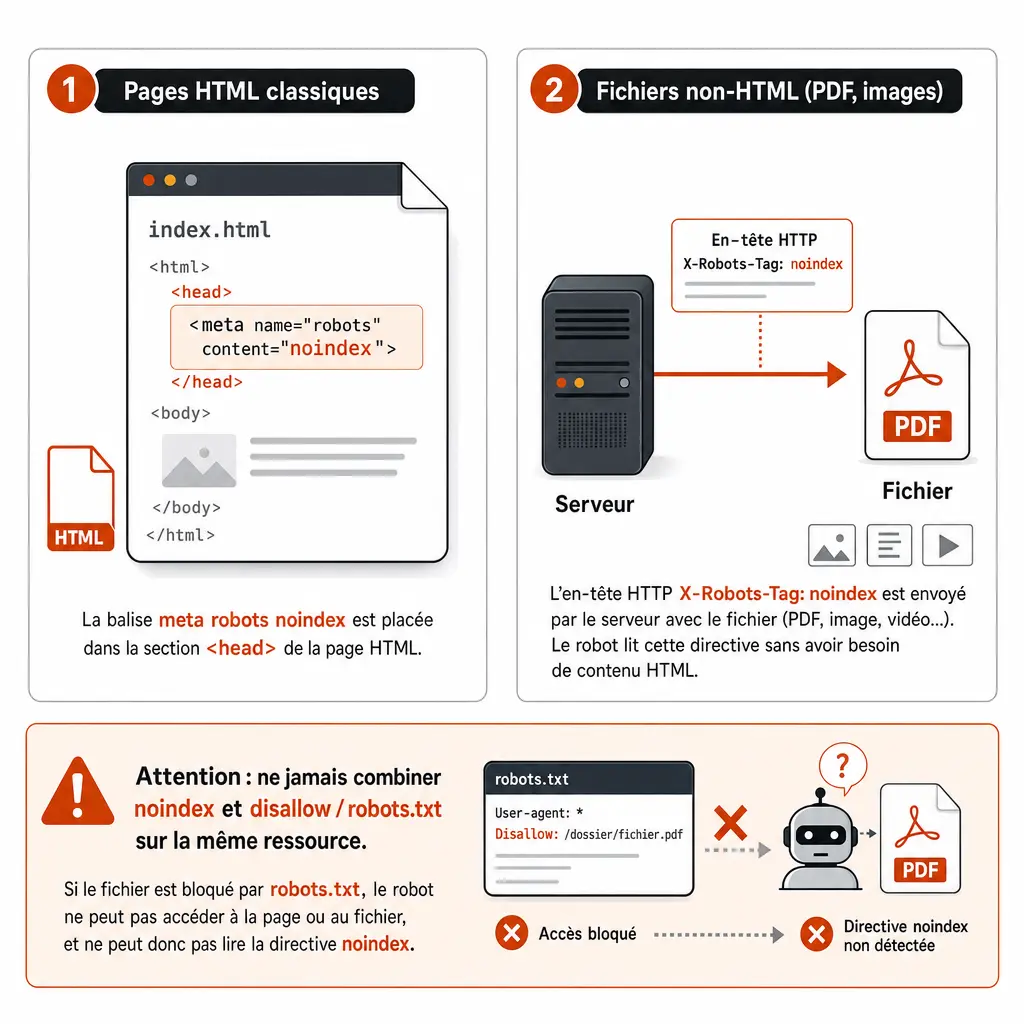
Il existe deux façons principales d’implémenter le noindex :
- Via la balise HTML meta robots, insérée dans l’en-tête de la page :
Cette méthode est adaptée aux pages HTML classiques.
- Via l’en-tête HTTP X-Robots-Tag, utile pour les ressources non-HTML comme les PDF, images ou vidéos. Par exemple :
Cette dernière méthode s’applique directement au serveur, ce qui est plus propre pour les fichiers statiques.
Différences clés avec robots.txt, disallow, nofollow et canonical
Il faut distinguer clairement noindex des autres directives, comme le rappelle le glossaire SEO d’Abondance :
| Directive | Fonction | Impact sur crawl et indexation |
|---|---|---|
| noindex | Empêche l’indexation | Crawl autorisé, page non indexée |
| disallow | Bloque le crawl | Aucun accès au robot, impossibilité de lire noindex |
| robots.txt | Bloque le crawl | Pareil que disallow |
| nofollow | Empêche le suivi des liens | Pas d’impact direct sur l’indexation de la page |
| canonical | Indique la page préférée (duplication) | Permet d’indiquer la version principale, mais n’empêche pas toujours l’indexation secondaire |
Cette clarification est souvent négligée, causant des erreurs pénalisantes.
Quand et pourquoi utiliser la balise noindex ?
Cas d’usage classiques : pages fines, staging, doublons, pages admin
La balise noindex est particulièrement utile :
- Sur des pages à contenu « fin » ou pauvre, qui ne méritent pas d’être indexées.
- Dans des environnements de staging ou de test, pour éviter l’indexation de versions non définitives.
- Pour les pages doublons non gérées par canonical ou difficilement consolidables.
- Sur les pages administratives, de login ou confirmations, inutiles en SEO.
Avantages SEO : optimisation du crawl budget et gestion du contenu dupliqué
Le noindex optimise le crawl budget en orientant les robots vers les pages stratégiques à indexer, optimisant ainsi la qualité du référencement global. Il contribue aussi à résoudre les problèmes classiques de contenu dupliqué, en limitant le nombre de pages concurrentes sans supprimer leur exploration.
Intégration avec d’autres stratégies SEO : lien avec l’URL canonique et le cocon sémantique
Dans une stratégie SEO avancée, il faut bien articuler noindex avec les URL canoniques. Par exemple, le noindex peut exclure les pages peu pertinentes, tandis que le canonical concentre la valeur SEO sur la version principale. Cette gestion finement dosée préserve la cohérence du cocon sémantique, où même des pages non indexées participent au maillage interne et à la circulation du jus SEO.
Bonnes pratiques et précautions à respecter
Ne jamais combiner noindex et disallow sur la même page
Cette erreur est fréquente : bloquer l’accès au crawler via robots.txt ou disallow empêche la détection de la balise noindex. Résultat, la page reste indexée malgré la directive, ce qui est contre-productif.
Éviter le noindex accidentel et surveiller les pages noindexées
Un noindex mal placé peut nuire à la visibilité d’une page importante. Il faut donc procéder à des audits réguliers, via des outils d’analyse SEO, pour détecter et corriger rapidement toute directive accidentelle.
Utilisation des plugins WordPress (Yoast SEO, Rank Math) pour gérer le noindex
Pour les sites WordPress, des plugins comme Yoast SEO ou Rank Math facilitent grandement la mise en place du noindex, sans modifier le code. Ils offrent une interface simple pour configurer les directives selon le type de contenu, réduisant le risque d’erreur humaine.
Diagnostic et arbitrage avancés autour du noindex
Vérification de la directive noindex via curl et Google Search Console
Pour vérifier techniquement l’application du noindex, deux commandes distinctes sont nécessaires — une par méthode d’implémentation. Pour repérer la balise meta dans le code source :
« `bash curl -sL -A « Mozilla/5.0 » https://votresite.com/votre-page | grep -i ‘name= »robots »‘ « `
Cette commande télécharge le HTML complet de la page et filtre la ligne contenant la balise meta robots — un simple curl -I ne le permettrait pas, puisqu’il ne renvoie que les en-têtes HTTP, jamais le corps de la page. Pour vérifier le header HTTP X-Robots-Tag (la méthode utilisée notamment sur les ressources non-HTML comme les PDF) :
« `bash curl -sIL https://votresite.com/votre-page | grep -i ‘x-robots-tag’ « `
Par ailleurs, Google Search Console permet une inspection précise de chaque URL pour confirmer que Googlebot détecte et respecte la directive.
Arbitrage entre noindex, canonical et redirection 301
Le choix entre noindex, canonical et redirection dépend du contexte :
- La redirection 301 est préférable pour supprimer définitivement une URL.
- Le canonical sert à gérer des duplications de contenu proches.
- Le noindex exclut une page du référencement tout en la laissant accessible.
Effets secondaires du noindex sur le maillage interne et le jus SEO
Même désindexée, une page avec noindex transmet du jus SEO tant qu’elle reste crawlée. Si la fréquence de crawl venait à diminuer, cette transmission perdrait en efficacité — un point à surveiller pour ne pas fragiliser le maillage interne des pages voisines.
Lien avec la désindexation : causes, diagnostic et remèdes
La balise noindex est un levier fréquemment utilisé dans les stratégies de désindexation. En lien avec le cluster « désindexation : causes, diagnostic et remèdes », elle doit être paramétrée avec une attention particulière pour éviter des suppressions non souhaitées ou prolongées.
Ressources complémentaires et maillage interne
Comprendre l’essor des marketplaces
L’essor des marketplaces pose les mêmes enjeux de gestion des doublons et des pages à faible valeur ajoutée que ceux traités ici avec le noindex.
Explorer l’affiliation et Google Discover
L’affiliation et Google Discover reposent aussi sur un bon arbitrage entre pages à indexer et pages à exclure — deux leviers à connaître pour utiliser noindex à bon escient.
📬 Envie d’aller plus loin ?
Je partage chaque weekend des conseils concrets pour créer, optimiser et monétiser ta présence en ligne (plateformes, SEO, copywriting…).
Pas de spam. Pas de blabla.
Juste une newsletter utile, écrite à la main par un freelance qui vit de ses contenus.
🎁 En bonus à l’inscription :
➡️ Un audit SEO ou appel stratégique offert (pour abonnés uniquement)
FAQ
Le noindex fait-il perdre le PageRank accumulé sur une page ?
Non, pas immédiatement : une page en noindex continue de transmettre du PageRank via ses liens internes tant que Google continue de la crawler. Mais Google espace progressivement ses visites sur les pages exclues de l’index, si bien que cette transmission s’affaiblit avec le temps. Mieux vaut donc éviter de concentrer vos liens de maillage les plus stratégiques uniquement sur des pages noindexées.
Combien de temps faut-il pour qu’une page désindexée disparaisse des résultats Google ?
Il n’y a pas de délai fixe : la page ne disparaît des résultats qu’au prochain passage du robot sur cette URL, ce qui prend généralement de quelques jours à plusieurs semaines selon la fréquence de crawl de la page. Pour accélérer ce délai, l’inspection d’URL dans Google Search Console permet de demander un nouveau passage ciblé ; l’outil de suppression d’URL peut quant à lui masquer la page des résultats en quelques heures, le temps que la directive noindex soit officiellement prise en compte.