Le robots.txt est le fichier que les robots d’exploration lisent en premier sur votre site pour savoir quelles pages ils peuvent explorer. Une page qu’il bloque peut pourtant rester dans les résultats de Google.
L’essentiel
- Le robots.txt gère l’exploration (le crawl) : il n’empêche pas une page d’être indexée.
- Quatre directives suffisent, dans un fichier unique à la racine du site, encodé en UTF-8 : User-agent, Disallow, Allow et Sitemap.
- Bloquer des CSS ou du JavaScript dont la page a besoin, ou compter sur Disallow pour désindexer, sont des erreurs classiques.
- Les crawlers IA ont chacun leur user-agent, mais le respect du fichier reste volontaire.
AFFICHER LE SOMMAIRE
Ce que fait vraiment le robots.txt
C’est un fichier texte placé à la racine du site. Il repose sur le Robots Exclusion Protocol, proposé en 1994 et standardisé par l’IETF en 2022 (RFC 9309).
Son rôle principal : limiter la charge de requêtes sur le serveur et orienter les robots vers les pages utiles, ce qui optimise le budget de crawl, c’est-à-dire le nombre de pages qu’un robot explore sur votre site.
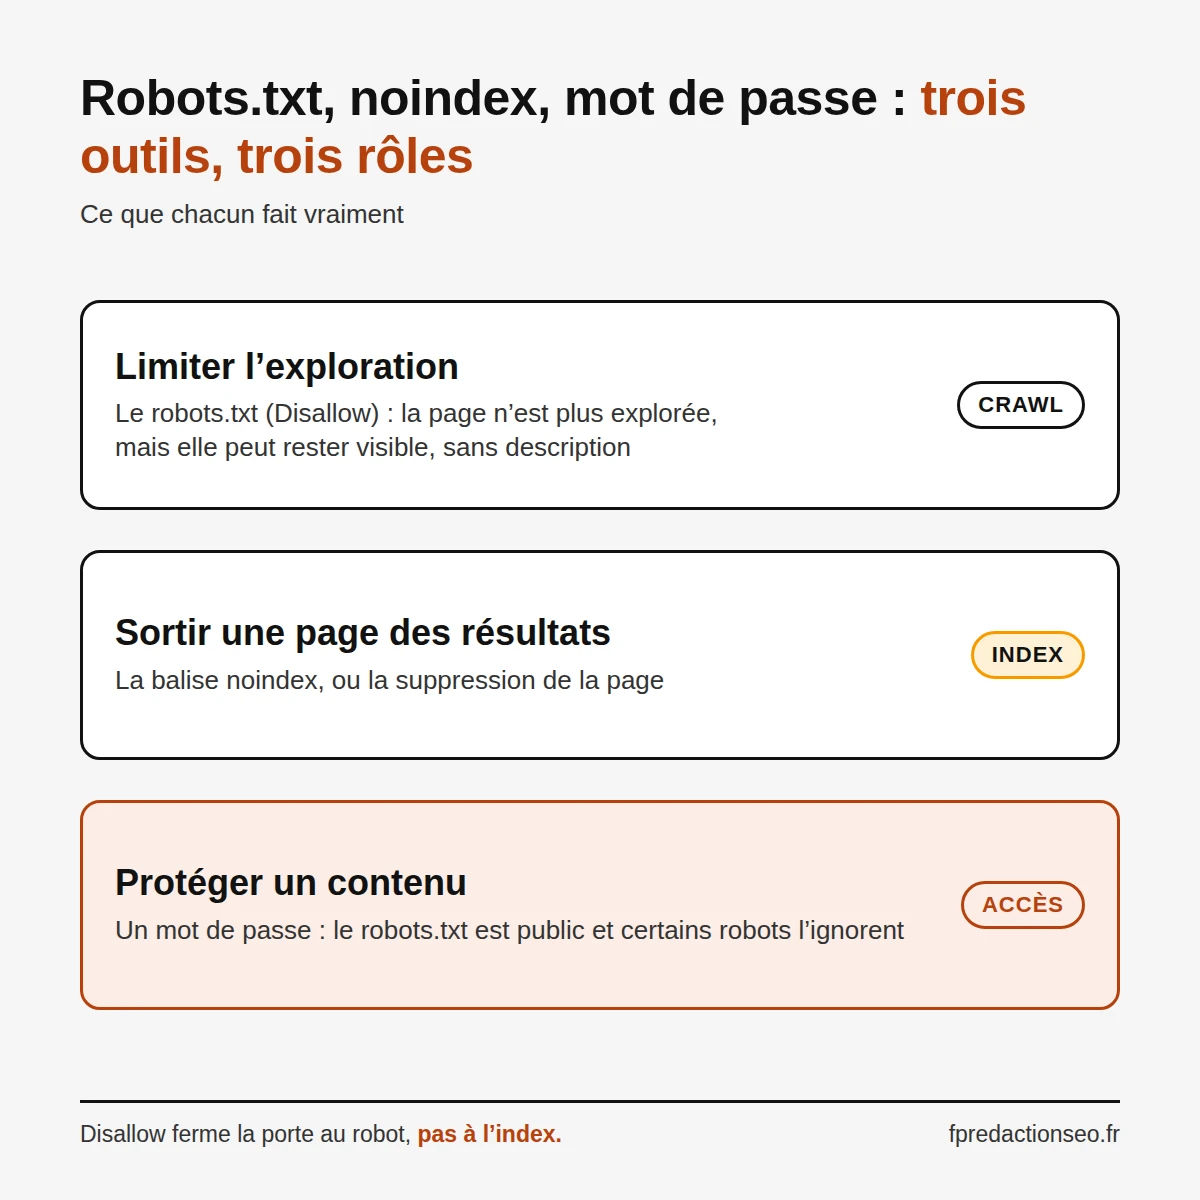
Une directive Disallow bloque l’exploration, pas l’affichage dans les résultats. Une page bloquée peut rester visible, sans description, selon Google, si d’autres sites pointent vers elle. Pour qu’elle disparaisse, il faut une balise noindex, un mot de passe ou la suppression de la page.
Ne combinez pas Disallow et noindex sur la même page. Google signale qu’associer des règles d’exploration et d’indexation peut créer des conflits : un Disallow empêche Googlebot de lire le noindex, et la page reste susceptible d’apparaître dans les résultats. Retirez d’abord le Disallow.
Écrire le fichier
Quatre directives suffisent :
User-agent: le robot visé, ou*pour tous (les AdsBot de Google doivent être nommés).Disallow: le chemin à ne pas explorer, qui commence par/.Allow: la levée d’une interdiction sur un sous-chemin.Sitemap: l’URL complète de votre plan du site.
Voici un exemple minimal :
User-agent: *
Disallow: /recherche/
Allow: /recherche/aide/
Sitemap: https://www.votresite.fr/sitemap.xml
Ici, /recherche/ est interdit, mais /recherche/aide/ reste exploré : en cas de conflit, la règle la plus précise, c’est-à-dire le chemin le plus long, l’emporte (RFC 9309). Attention à Disallow: / : cette ligne seule interdit l’exploration de tout le site.
Le fichier s’appelle robots.txt, il est unique, encodé en UTF-8, et il se trouve à la racine de l’hôte, jamais dans un sous-répertoire. Les règles sont sensibles à la casse, # ouvre un commentaire et le joker * est accepté par toutes les règles, sauf Sitemap.
Pour vérifier, ouvrez votresite.fr/robots.txt dans un navigateur ou lancez curl, puis utilisez la Search Console, qui permet de tester si une URL est bloquée pour Googlebot.
Cinq erreurs fréquentes
- Bloquer les CSS et le JavaScript. Google doit pouvoir les lire pour comprendre la page. Ne les bloquez que si la page reste compréhensible sans eux.
- Compter sur Disallow pour désindexer. Il bloque l’exploration, pas la présence dans l’index : voir plus haut.
- Lister des chemins sensibles. Le fichier est public. Y écrire un dossier d’administration, c’est le signaler aux pirates et aux concurrents.
- Négliger la préproduction. Une version de test sans blocage peut finir indexée par Google. Un mot de passe protège réellement la préproduction, ce que le robots.txt ne fait pas.
- Écrire un noindex dans le robots.txt. Cette directive n’a jamais été officielle : Google a cessé de la prendre en compte le 1er septembre 2019.
Robots.txt et bots IA
Chaque crawler IA a son propre user-agent : GPTBot (OpenAI), ClaudeBot (Anthropic), Google-Extended (Google). Bloquer l’un d’eux n’affecte pas votre référencement Google. Il suffit d’une ligne User-agent: GPTBot suivie de Disallow: /.
Selon le Blog du Modérateur, la CNIL a classé en juin 2025 le robots.txt parmi les signaux techniques d’opposition à prendre en compte par les acteurs de l’IA. Le respect repose pourtant sur la bonne volonté des robots.
Bloquer l’entraînement n’est pas bloquer la recherche. Selon la revue de presse d’Algorithme, 17 % des sites du réseau Cloudflare bloquent l’entraînement des IA d’une manière ou d’une autre, contre moins de 1 % pour les robots de recherche.
Le llms.txt est un autre fichier : il fournit des informations résumées aux modèles de langage, sans régler l’accès. Olivier Duffez le juge inutile.
Robots.txt, noindex, canonical : qui fait quoi
Le robots.txt, le noindex et l’URL canonique se complètent : le robots.txt règle l’exploration, le noindex règle l’index, et l’URL canonique désigne la version à retenir entre plusieurs pages proches.
Il sert à écarter les pages peu importantes ou redondantes. Sur une boutique WooCommerce, par exemple, les URLs en ?add-to-cart= apparaissent normalement parmi les pages bloquées de la Search Console. Dans un cocon sémantique, il évite de disperser les robots hors des pages utiles.
Relisez votre robots.txt à chaque refonte ou migration, Search Console ouverte, et vérifiez qu’il ne bloque ni vos articles ni leurs ressources, surtout si vous visez Google Discover.
FAQ
Faut-il bloquer GPTBot ou ClaudeBot sur son site ?
Cela dépend de ce que vous acceptez de voir réutilisé : bloquez-les si vous refusez que vos contenus alimentent ces modèles. Cela n’affecte pas votre référencement Google. Le blocage reste une demande : le respect du fichier dépend de la bonne volonté des robots.
Un site doit-il obligatoirement avoir un fichier robots.txt ?
Non, le fichier est facultatif. Avec certains CMS, comme Wix ou Blogger, sa gestion peut même être indisponible : ce sont alors les paramètres de visibilité du CMS qui s’appliquent. Pour contrôler l’indexation, utilisez la balise noindex.
Le robots.txt peut-il protéger une page confidentielle ?
Non. Le fichier est public, certains robots l’ignorent et une page bloquée peut rester visible dans les résultats si d’autres sites y font référence. Pour protéger une information sensible, utilisez un mot de passe.
📬 Envie d’aller plus loin ?
Je partage chaque weekend des conseils concrets pour créer, optimiser et monétiser votre présence en ligne (plateformes, SEO, copywriting…).
Pas de spam. Pas de blabla.
Juste une newsletter utile, écrite par un freelance qui vit de ses contenus.
🎁 En bonus à l’inscription :
➡️ Un audit SEO ou appel stratégique offert (pour abonnés uniquement)