Sur le web, la visibilité d’un site repose largement sur l’action des robots d’exploration (crawlers). Ces logiciels automatisés parcourent les pages internet, analysent leur contenu et permettent aux moteurs de recherche de les indexer. Comprendre ce qu’est un crawler, comment il fonctionne et comment s’adapter aux évolutions récentes, notamment avec les crawlers liés à l’intelligence artificielle, est désormais essentiel pour toute stratégie digitale sérieuse.
Je vous propose une synthèse claire sur le rôle et le fonctionnement des robots d’exploration, ainsi qu’une mise en perspective indispensable pour 2026, où SEO et crawlers IA/GEO cohabitent et redéfinissent les enjeux de la visibilité en ligne.
L’essentiel
- Un robot d’exploration, ou crawler, automatise la découverte et l’indexation des pages web en suivant les liens.
- Les crawlers SEO classiques (Googlebot, Bingbot) se distinguent nettement des crawlers IA/GEO (GPTBot, ClaudeBot).
- En 2026, il faut adapter son robots.txt et poser un fichier llms.txt pour rester visible aussi bien pour les crawlers SEO que pour les crawlers IA.
- Les critères de crawl dépendent de la popularité, du maillage interne, de la fraîcheur et des contraintes serveur.
- Autoriser les crawlers IA est une stratégie gagnante en B2B pour capter un nouveau trafic, malgré certains risques.
AFFICHER LE SOMMAIRE
Qu’est-ce qu’un robot d’exploration (crawler) ?
Définition et terminologie
Un robot d’exploration, ou crawler, est un logiciel qui navigue automatiquement sur le web pour collecter des données. Il suit les liens hypertextes d’une page à une autre pour découvrir et analyser les contenus. On utilise aussi souvent les termes spider, bot ou robot d’indexation, mais chacun porte une nuance :
- Crawler désigne le logiciel qui explore systématiquement le web.
- Spider est un terme plus ancien, souvent utilisé pour désigner un crawler effectuant un ramassage orienté.
- Bot est un terme générique pour tout agent logiciel automatisé.
- Robot d’indexation insiste sur la fonction d’organisation et d’indexation des contenus.
- Le user-agent crawler correspond à l’identifiant envoyé par le robot HTTP pour signaler sa présence aux serveurs.
Cette distinction importe pour configurer précisément votre site (notamment via robots.txt) et comprendre qui vous rend visite.
Historique des crawlers
Les premiers crawlers apparaissent dans les années 1990. Le WWW Wanderer (1993) est le pionnier, suivi du WebCrawler (1994), qui a donné son nom à la technologie. Avec la montée en puissance des moteurs de recherche, Googlebot s’impose comme le moteur de crawl dominant. Aujourd’hui, l’essor des crawlers IA/GEO (comme GPTBot ou ClaudeBot) marque un tournant : ces robots ne se contentent pas d’indexer, ils extraient du contenu pour entraîner des modèles de langage, ouvrant un nouveau paradigme en référencement.
Fonctionnement d’un robot d’exploration
Processus d’exploration et indexation
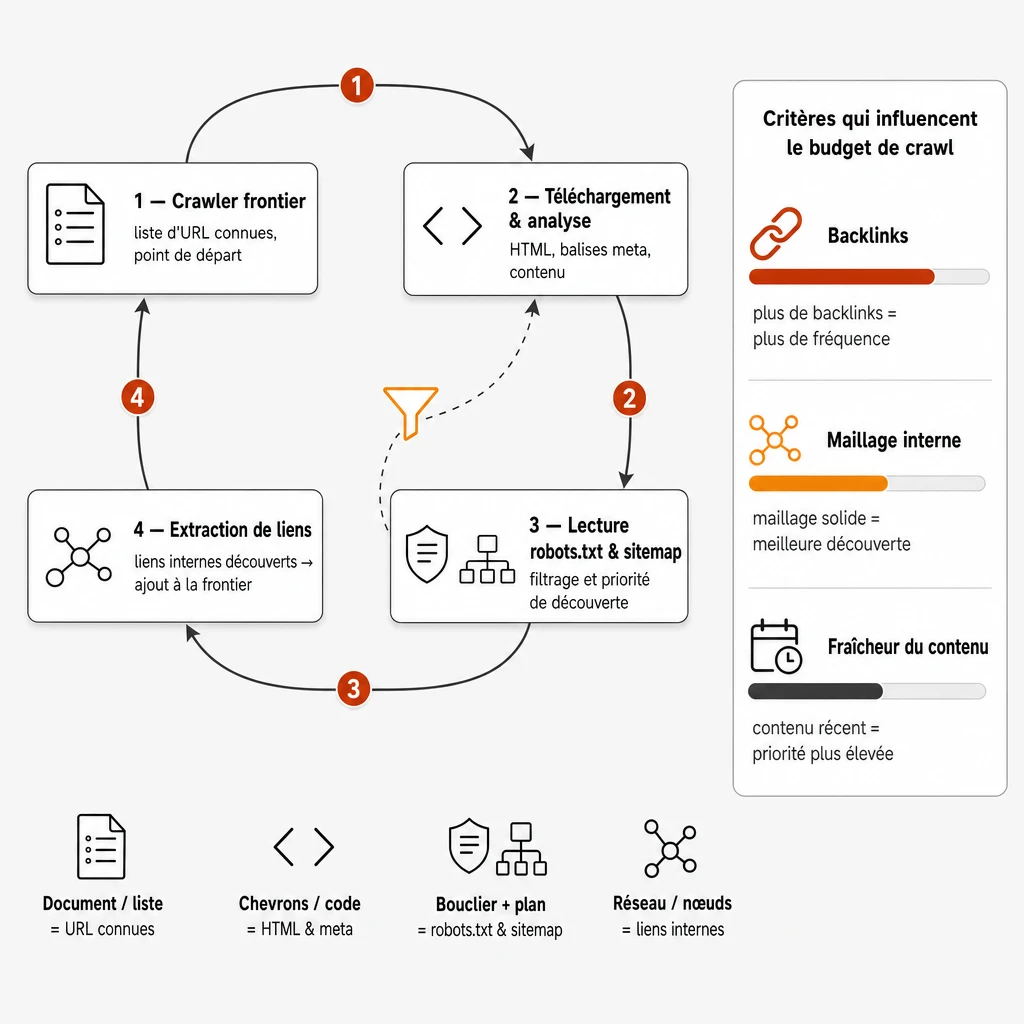
Le crawler débute avec une liste d’URL connues, appelée crawler frontier. Il visite ces pages, analyse le contenu HTML, lit les balises meta et extrait les liens pour poursuivre sa route. Ce processus itératif permet de découvrir l’intégralité du site, mais aussi les liens externes.
Les directives du fichier robots.txt guident le robot en lui indiquant les zones à exclure, tandis que le sitemap XML facilite la découverte des pages importantes et récentes.
Métriques et critères de crawl
Le moteur de recherche décide la fréquence et la profondeur du crawl basé sur plusieurs critères :
- Nombre de backlinks : plus une page est citée, plus elle est jugée importante.
- Maillage interne : une bonne structure facilite la découverte rapide des pages.
- Trafic et popularité : un site fréquenté est crawlé plus souvent.
- Fraîcheur du contenu : les modifications récentes incitent à recrawler.
Ces facteurs influent sur le budget de crawl, qui correspond au temps et aux ressources serveur alloués au robot.
Outils pour auditer le crawl et corriger les erreurs
Pour mieux gérer cette exploration, plusieurs outils sont indispensables :
- Screaming Frog : audits techniques et crawl simulé.
- Botify et Oncrawl : analyses avancées du crawl et performances SEO.
- Google Search Console : rapports sur l’exploration réelle des bots de Google.
Bien maîtriser ces outils vous aide à repérer les pages orphelines, corriger les erreurs de crawl et assurer une meilleure indexation.
Typologie des crawlers : SEO classique vs crawlers IA/GEO
Les crawlers SEO traditionnels
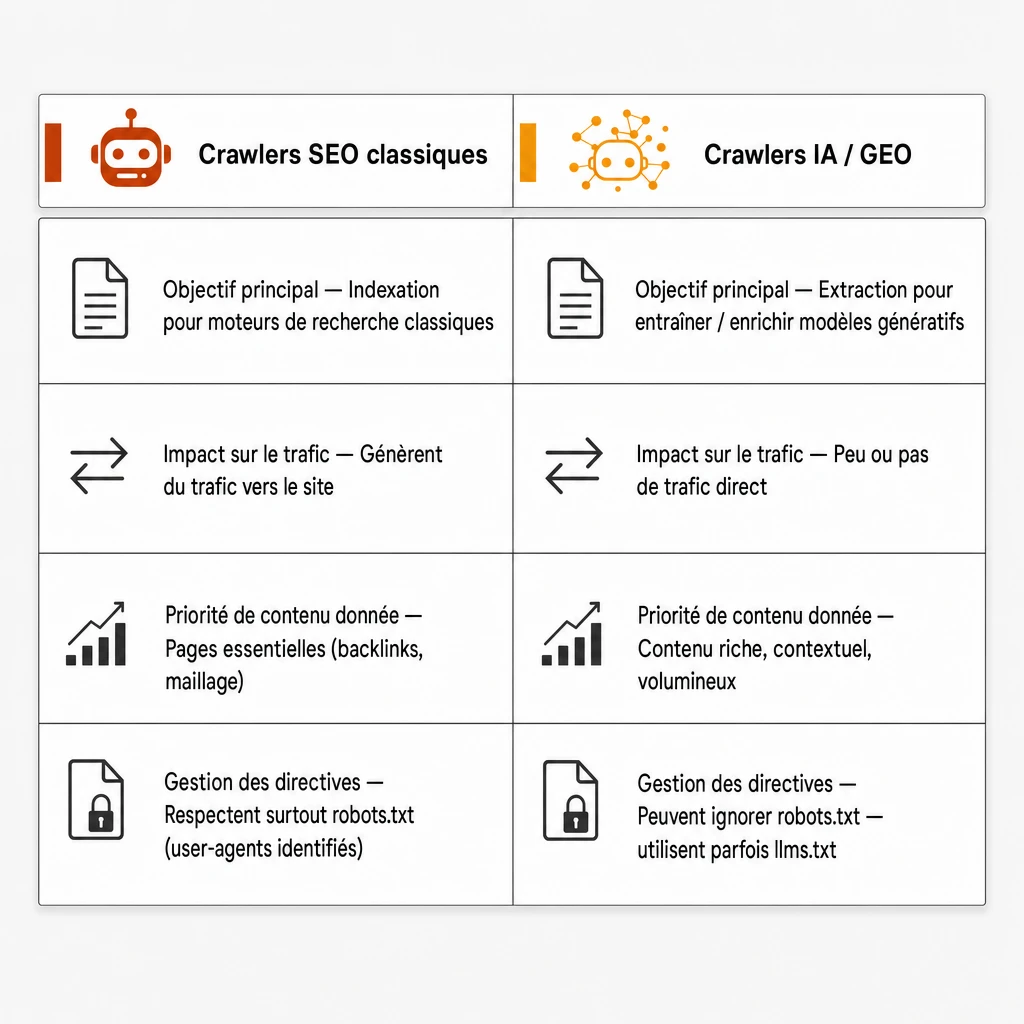
Ces acteurs historiques comprennent principalement Googlebot, Bingbot et YandexBot. Leur rôle est clair : explorer les pages pour alimenter l’index des moteurs de recherche classiques. Ils renvoient ensuite les utilisateurs vers les sites en fonction de critères SEO.
Ces crawlers respectent généralement les consignes des fichiers robots.txt et ont des user-agent bien identifiés.
Les crawlers IA et GEO : un nouveau paradigme
Avec l’essor des modèles de langage, de nouveaux crawlers apparaissent : GPTBot, ClaudeBot, Google-Extended ou PerplexityBot. Ils ne visent pas à générer un résultat de recherche traditionnel mais à extraire des contenus pour entraîner ou alimenter des systèmes génératifs.
Contrairement aux crawlers SEO, ils valorisent le contenu contextuel et volumineux, et ne renvoient pas forcément de trafic direct au site source. Ils posent des enjeux particuliers de gestion et de visibilité.
Tableau comparatif SEO vs GEO
| Critère | Crawlers SEO | Crawlers IA/GEO |
|---|---|---|
| Objectif principal | Indexation pour moteurs de recherche classiques | Entraînement et enrichissement des modèles de langage |
| Impact sur trafic | Génèrent du trafic vers le site | Peu ou pas de trafic direct |
| Priorité donnée | Pages les plus importantes via backlinks et maillage | Contenu riche, contextuel, accessible |
| Gestion des directives | Respect strict de robots.txt | Parfois ignorent ou nécessitent fichiers spécifiques (llms.txt) |
| Visibilité en 2026 | Encore critique | En forte croissance, stratégique |
Adapter son site aux crawlers SEO et IA en 2026
Les bonnes pratiques SEO classiques
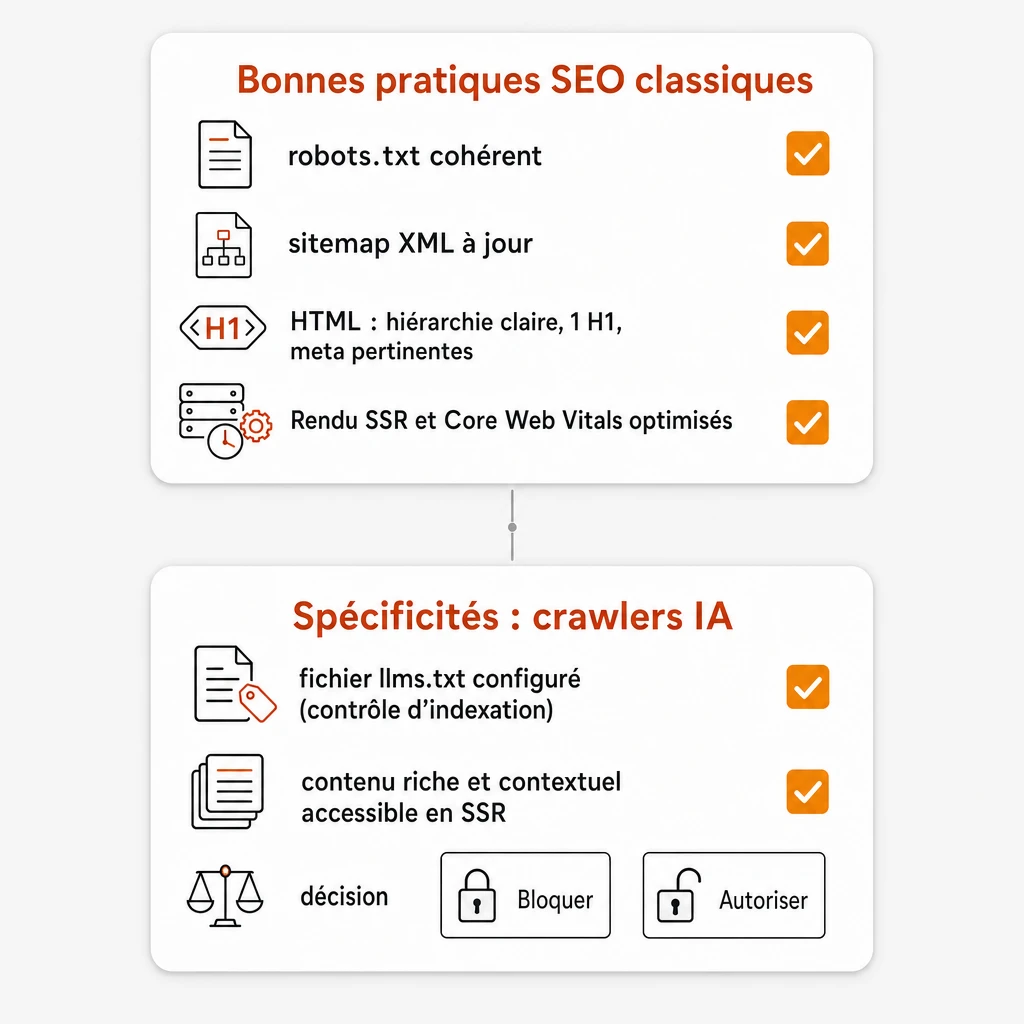
Gardez une configuration robots.txt cohérente pour ne pas bloquer par erreur les crawlers essentiels. Maintenez un sitemap XML à jour afin de faciliter la découverte des pages.
Soignez le code HTML : une hiérarchie claire avec un seul H1, des balises meta pertinentes, et un contenu bien structuré. Privilégiez le rendu côté serveur (SSR) pour un chargement optimal et une meilleure lecture du contenu.
Veillez aussi à la santé technique avec des Core Web Vitals au vert et un maillage interne efficace.
Les spécificités liées aux crawlers IA
Pour ce type de crawlers, le fichier llms.txt devient un outil majeur. Il permet de spécifier quelles parties du site sont ouvertes à l’indexation IA.
Le contenu doit être riche, contextuel et idéalement accessible en SSR. Le rendu client-side JavaScript peut limiter la compréhension par ces robots.
Faut-il bloquer ou autoriser les crawlers IA ?
Bloquer ces crawlers protège votre contenu contre une utilisation non souhaitée mais vous prive de toute exposition dans les réponses des assistants IA, qui deviennent un nouveau canal de visibilité.
À l’inverse, une autorisation contrôlée favorise la visibilité et la captation de trafic B2B innovant, mais nécessite une surveillance accrue pour éviter les abus.
La tendance pour 2026, surtout en B2B, est d’autoriser ces crawlers tout en maîtrisant via llms.txt.
Enjeux et perspectives : le rôle stratégique des crawlers
Impact sur la visibilité en ligne
Sans crawl, pas d’indexation ; sans indexation, pas de présence sur le web. Ce sont eux qui décident, en silence, si un site existe vraiment aux yeux des moteurs de recherche et des IA génératives.
Leur rôle dépasse largement le SEO traditionnel pour inclure le référencement GEO et le référencement via IA, une tendance appelée Generative Engine Optimization.
Lien avec d’autres leviers digitaux
Le fonctionnement des crawlers s’articule avec plusieurs autres leviers techniques du référencement. Un cocon sémantique bien construit facilite leur découverte des pages stratégiques, la configuration du fichier robots.txt conditionne les zones qu’ils explorent réellement, et une URL canonique mal posée peut les orienter vers la mauvaise version d’une page. Une fois le contenu exploré, encore faut-il qu’il soit bien indexé pour espérer une exposition dans Google Discover.
Maîtriser ces aspects, c’est garantir une exploration optimale, indispensable pour toucher une audience large et qualifiée à l’ère numérique actuelle.
FAQ
Comment vérifier concrètement que Googlebot explore bien mon site ?
Le rapport de couverture de Google Search Console reste le seul moyen fiable de le savoir : il liste les pages réellement explorées, celles exclues et le motif exact de l’exclusion, directement depuis les logs de Googlebot. Un guide pratique de Google Search Console existe pour l’exploiter sans se perdre dans l’interface.
Le budget de crawl s’applique-t-il aussi aux crawlers IA comme GPTBot ?
Pas de la même manière : le budget de crawl, tel qu’il est mesuré et optimisé pour les moteurs de recherche classiques, ne suit pas les mêmes règles de fréquence pour les crawlers IA. Ils consomment malgré tout de la bande passante serveur bien réelle, ce qui justifie de les surveiller avec les mêmes outils de logs que pour Googlebot.
Un petit site doit-il vraiment se soucier du fichier llms.txt ?
Pas dans l’urgence : les crawlers IA généralistes priorisent d’abord le contenu déjà autoritaire et déjà cité ailleurs. Mais poser un llms.txt minimal ne coûte que quelques minutes, et évite de découvrir, une fois le trafic de citation devenu stratégique, qu’aucune règle n’a jamais été posée pour ces robots.
📬 Envie d’aller plus loin ?
Je partage chaque weekend des conseils concrets pour créer, optimiser et monétiser ta présence en ligne (plateformes, SEO, copywriting…).
Pas de spam. Pas de blabla.
Juste une newsletter utile, écrite à la main par un freelance qui vit de ses contenus.
🎁 En bonus à l’inscription :
➡️ Un audit SEO ou appel stratégique offert (pour abonnés uniquement)