Comprendre le fonctionnement de l’indexation Google peut vous aider à assurer la visibilité de vos pages web. L’indexation est le processus par lequel Google stocke et organise les pages afin de les rendre accessibles dans ses résultats de recherche. Souvent confondu avec le crawl, ce mécanisme cache en réalité une double étape technique impliquant notamment le Googlebot traditionnel et le Web Rendering Service (WRS). Je vais vous détailler ces notions clés pour mieux saisir ce qui se passe en coulisses lors de l’indexation par Google.
L’essentiel
- L’indexation Google consiste à analyser et stocker les pages web pour qu’elles apparaissent dans les résultats de recherche.
- La différence entre crawl et indexation repose sur le téléchargement initial et l’analyse approfondie des pages.
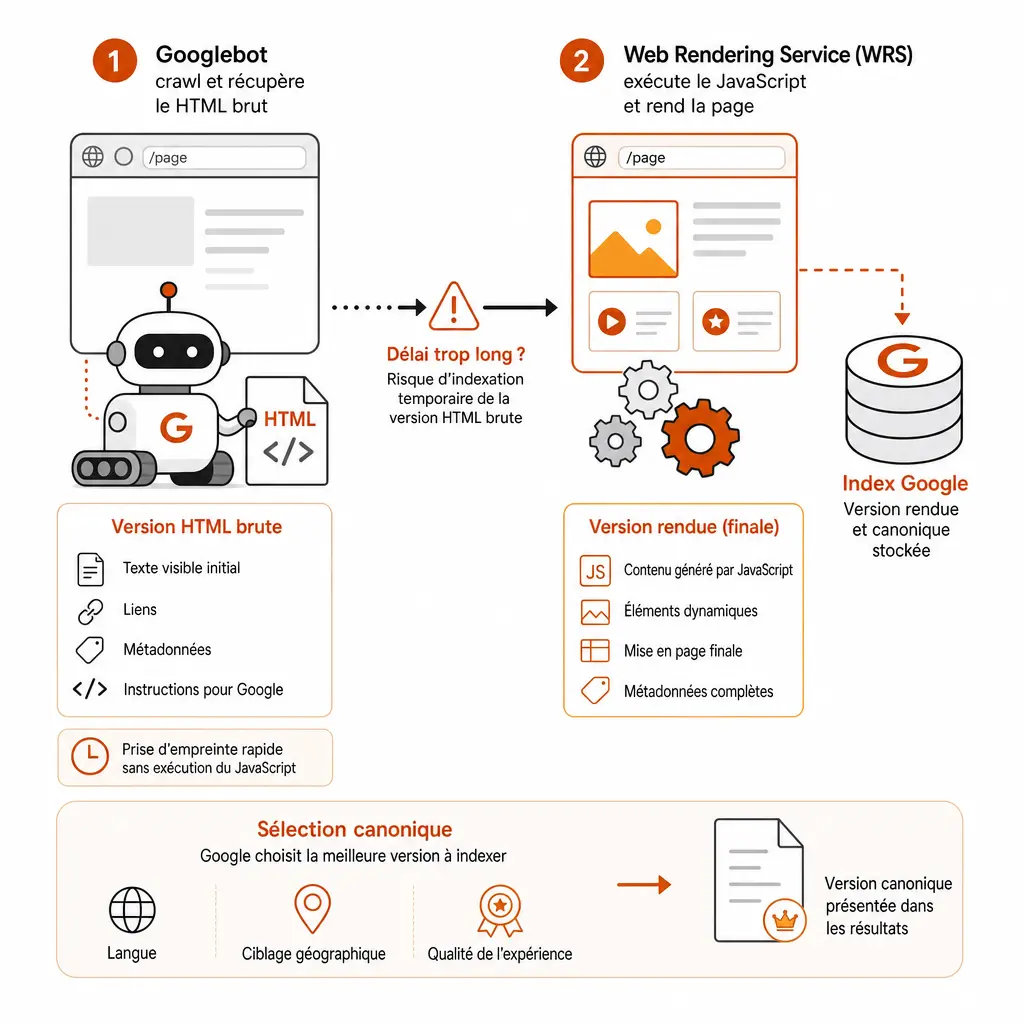
- Google utilise une double étape technique : le Googlebot récupère le HTML brut, puis le Web Rendering Service exécute le JavaScript pour indexer la version finale.
- Des outils comme l’inspection d’URL et le rapport de couverture dans Search Console permettent de vérifier l’état d’indexation de vos pages.
- Plusieurs facteurs empêchent l’indexation, notamment le contenu faible ou dupliqué, les directives noindex/robots.txt, ainsi que les erreurs liées aux pages orphelines et à la sélection canonique.
AFFICHER LE SOMMAIRE
Qu’est-ce que l’indexation Google ?
Définition et rôle de l’indexation
L’indexation Google désigne le processus par lequel Google analyse et stocke les pages web dans son index, une gigantesque base de données rassemblant des centaines de milliards de pages. C’est cette étape qui permet à une page d’apparaître dans les résultats de recherche.
Sans indexation, aucune page ne peut être proposée aux utilisateurs, quelle que soit sa qualité ou sa popularité. C’est donc une condition indispensable à la visibilité en ligne.
Différence entre crawl et indexation
Le crawl est la phase initiale où le robot d’exploration de Google, appelé Googlebot, visite un site et télécharge le contenu brut d’une page (HTML, images, vidéos). C’est une collecte de données.
L’indexation, elle, va plus loin : elle correspond à l’analyse approfondie, la compréhension du contenu ainsi que son stockage organisé dans l’index. Cette distinction est souvent mal comprise mais est essentielle pour diagnostiquer les problèmes de référencement.
Comment fonctionne le processus d’indexation chez Google ?
Le rôle du Googlebot traditionnel
Googlebot lance la procédure en récupérant la version HTML brute d’une page. Cette étape consiste à télécharger le code source qui contient le texte, les liens, les métadonnées et les instructions pour Google.
C’est une rapide prise d’empreinte, qui ne prend pas en compte le contenu généré ou modifié par JavaScript.
Le Web Rendering Service (WRS) et l’indexation de la version rendue
Ensuite, Google exécute le JavaScript grâce au Web Rendering Service (WRS), une technologie qui permet de rendre la page telle qu’un utilisateur la verrait dans son navigateur. Cette seconde étape vise à indexer la version finale, intégrant tous les contenus dynamiques.
Cette approche en deux temps est rarement vulgarisée, pourtant elle explique certains délais ou incohérences entre la page réelle et ce que Google affiche.
Risques liés à l’indexation temporaire de la version HTML brute
Un délai trop long entre le crawl initial et le rendu complet peut conduire Google à indexer une version HTML brute temporaire, donc incomplète ou partielle. Cela crée des risques : contenu mal interprété, absence d’éléments clés ou même incohérences dans l’index.
Il est donc important de surveiller ce processus, surtout pour les sites reposant largement sur des scripts pour charger du contenu.
Sélection canonique et stockage dans l’index
Lors de l’indexation, Google doit choisir parmi des versions similaires (par exemple URLs proches ou contenu dupliqué) une version canonique à stocker dans son index. Ce choix dépend de plusieurs critères : langue, ciblage géographique, qualité de l’expérience utilisateur.
La sélection canonique influence directement la façon dont votre contenu sera présenté dans les résultats.
Comment vérifier l’indexation de vos pages ?
Utiliser la recherche site: dans Google
La commande « site:votresite.com » dans Google offre un aperçu rapide des pages indexées visibles publiquement. C’est une méthode simple pour évaluer la présence globale de votre site dans l’index.
L’outil d’inspection d’URL dans Google Search Console
Pour un contrôle plus précis, l’inspection d’URL dans Search Console permet d’obtenir des informations détaillées : statut d’indexation, dernière date de crawl, erreurs détectées, et même la version rendue.
C’est l’outil de référence pour diagnostiquer le statut exact d’une page.
Le rapport de couverture dans Search Console
Search Console propose également un rapport de couverture qui regroupe l’état global d’indexation de votre site, les erreurs bloquantes, les pages exclues, et d’autres alertes pertinentes.
Ce rapport est essentiel pour suivre en continu l’état de votre indexation et anticiper les problèmes.
Pourquoi certaines pages ne sont-elles pas indexées ?
Contenu de faible qualité ou dupliqué
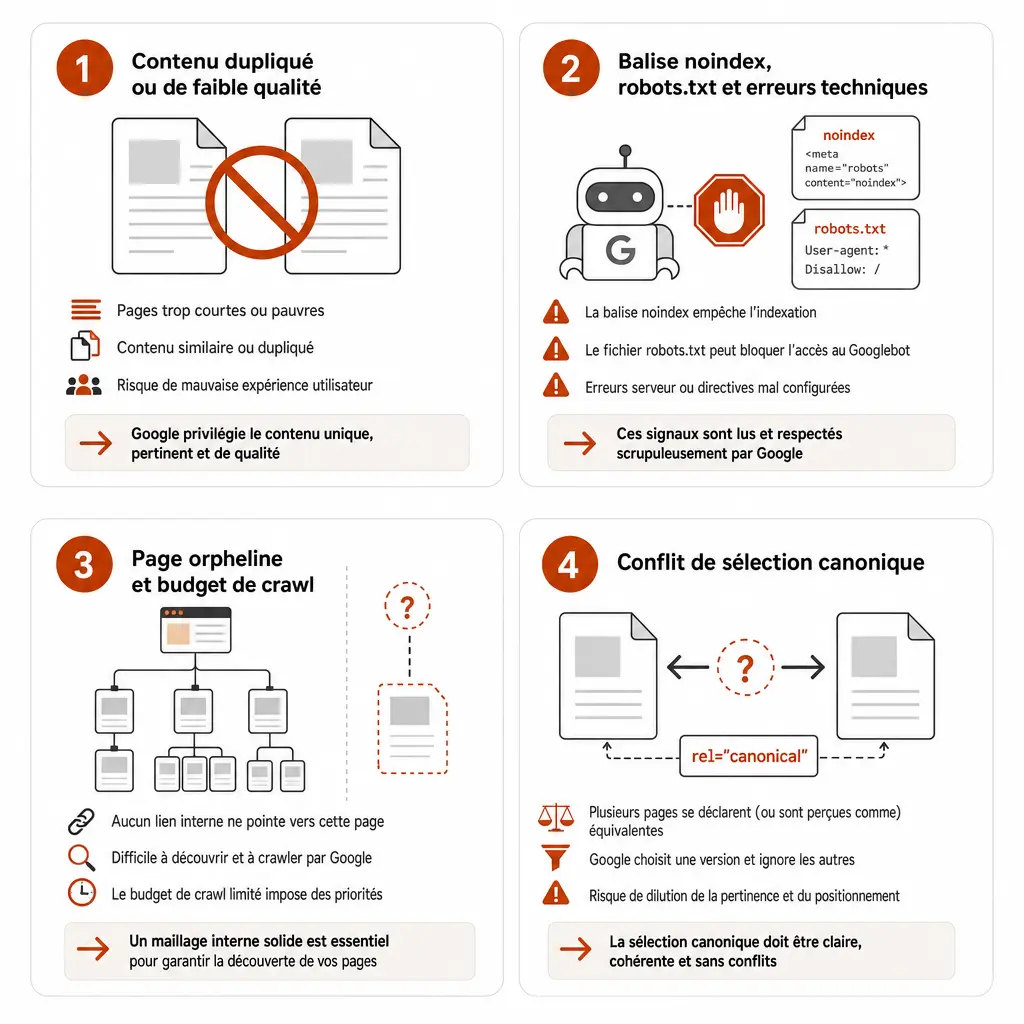
Google privilégie le contenu unique, pertinent et de qualité. Les pages pauvres, trop courtes ou similaires à d’autres risquent de ne jamais être indexées pour éviter la dilution et la mauvaise expérience utilisateur.
Balises noindex, robots.txt et erreurs techniques
Certaines directives peuvent volontairement ou par erreur bloquer l’indexation : la balise noindex, le fichier robots.txt qui interdit l’accès au Googlebot, ou des erreurs serveur.
Ces mécanismes sont expliqués dans la documentation officielle et lus attentivement par Google.
Pages orphelines et problèmes de budget de crawl
Une page orpheline, qui ne reçoit aucun lien interne, sera difficile à découvrir et à crawler par Google. Le budget de crawl, limité pour les sites importants, peut aussi entraîner des priorités qui excluent certaines URLs.
Bien structurer votre maillage interne — notamment via un cocon sémantique — est donc un levier fondamental.
Problèmes liés à la sélection canonique
Enfin, une mauvaise gestion de l’URL canonique peut conduire Google à ignorer une page au profit d’une autre, même moins pertinente.
Il faut veiller à ce que la sélection canonique reflète correctement la version privilégiée et évite les conflits.
FAQ
Combien de temps faut-il pour que Google indexe une nouvelle page ?
Il n’existe pas de délai garanti : selon la popularité du site et la fréquence de crawl, l’indexation peut prendre de quelques heures à plusieurs semaines. Un site déjà bien crawlé sera généralement pris en compte plus vite qu’un domaine récent. Soumettre l’URL via l’inspection d’URL dans Search Console accélère le processus sans le garantir.
Comment savoir si une page a été désindexée plutôt que jamais indexée ?
Une page jamais indexée n’a simplement jamais été retenue par Google ; une page désindexée, elle, l’a été puis en est sortie, souvent après une erreur technique ou une pénalité survenue après coup. L’historique dans Search Console (position ancienne, trafic passé) permet de trancher. Si votre page a existé dans l’index avant de disparaître, consultez notre article sur la désindexation pour un diagnostic complet.
Un sitemap XML garantit-il l’indexation d’une page ?
Non : le sitemap XML sert uniquement à signaler l’existence d’une URL à Google, pas à forcer son indexation. Il facilite la découverte, surtout sur un gros site ou un domaine récent, mais Google reste libre d’ignorer une page jugée de faible qualité ou dupliquée. Le sitemap est un aiguillage, pas une garantie.
📬 Envie d’aller plus loin ?
Je partage chaque weekend des conseils concrets pour créer, optimiser et monétiser ta présence en ligne (plateformes, SEO, copywriting…).
Pas de spam. Pas de blabla.
Juste une newsletter utile, écrite à la main par un freelance qui vit de ses contenus.
🎁 En bonus à l’inscription :
➡️ Un audit SEO ou appel stratégique offert (pour abonnés uniquement)