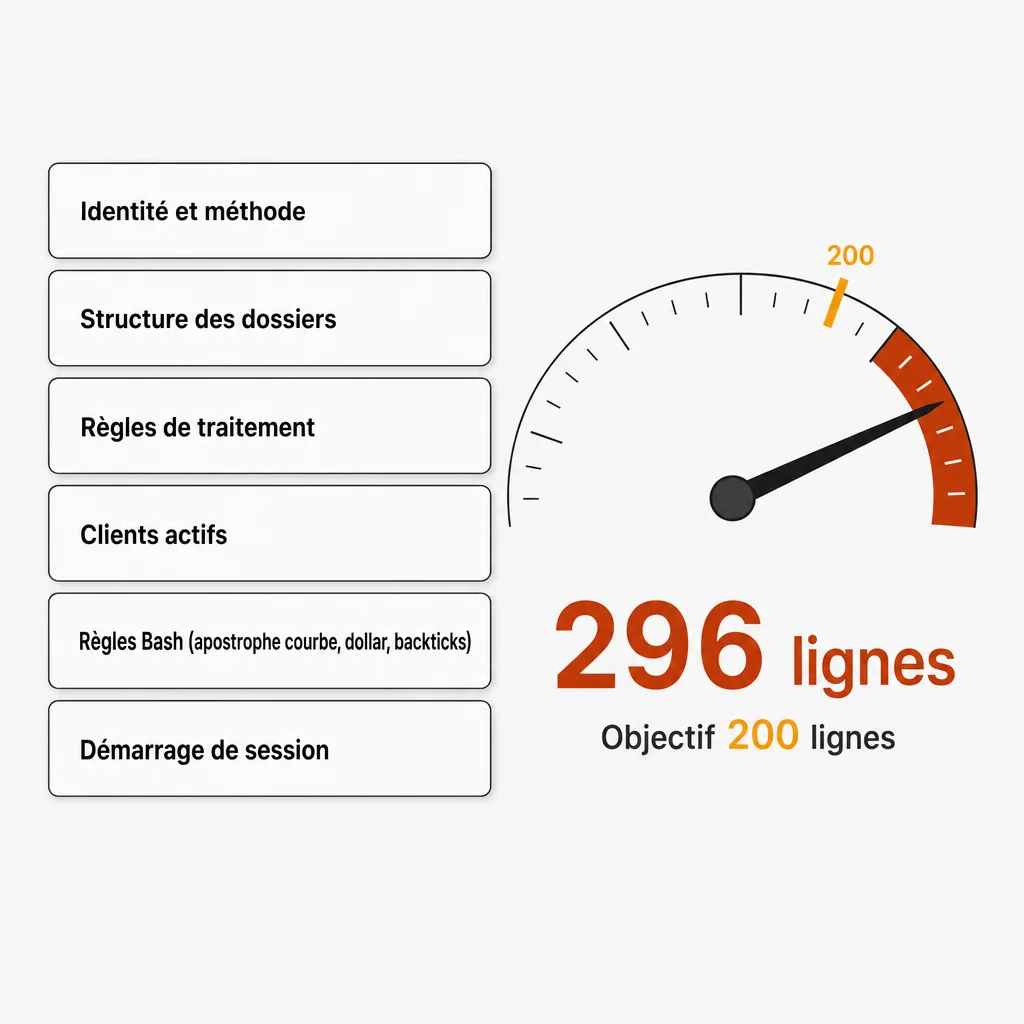
Mon CLAUDE.md fait 296 lignes, près de 50 % de plus que la cible de 200 lignes d’Anthropic, et il avait déjà dérivé en juillet.
Un agent IA comme Claude Code démarre chaque session avec une fenêtre de contexte vierge. Ce qu’il sait de votre projet vient de ce qu’on recharge à chaque démarrage, et le principal de ces rechargements est le fichier CLAUDE.md : sa mémoire écrite. Elle se cultive comme un jardin : elle grossit à chaque règle ajoutée et demande à être taillée.
L’essentiel
- Chaque session de Claude Code démarre avec un contexte vierge : le CLAUDE.md et l’auto memory sont rechargés.
- Claude lit le CLAUDE.md comme du contexte, pas comme une configuration imposée : pour interdire une action, il faut un hook.
- Le fichier grossit à mesure qu’on y ajoute des règles nées d’erreurs, et finit par se contredire s’il n’est pas relu.
- Anthropic vise moins de 200 lignes par fichier ; les imports n’allègent pas le contexte, alors que les règles par chemin le font ;
/doctor prompt-auditrepère les consignes périmées ou contradictoires. - Le fichier se cultive comme un jardin : on le taille et on l’audite régulièrement. L’auto dream, rapporté en test en mars 2026, ne figure pas dans la documentation officielle consultée.
AFFICHER LE SOMMAIRE
Pourquoi un agent IA a besoin d’une mémoire écrite
Un contexte vierge à chaque session
Claude Code démarre chaque session avec une fenêtre de contexte vierge. Rien de ce qui s’est dit hier n’y figure : ni les décisions prises, ni les erreurs corrigées. Deux mécanismes portent une partie de cette connaissance d’une session à l’autre, et tous deux sont chargés au démarrage. Le premier est le CLAUDE.md, que vous rédigez. Le second est l’auto memory, un dossier de notes que Claude écrit lui-même au fil de vos corrections ; son index, MEMORY.md, est chargé sur ses 200 premières lignes ou ses 25 Ko.
Sans ces deux couches, chaque conversation repart de zéro : l’agent redemande ce que vous lui avez déjà expliqué ou refait une erreur déjà corrigée. Mike Codeur, créateur de contenu sur ces outils, affirme que sans trace écrite des options déjà écartées, l’agent repropose à chaque session une approche que vous aviez rejetée.
Ce que CLAUDE.md peut et ne peut pas faire
Claude lit le CLAUDE.md comme du contexte, pas comme une configuration imposée. La documentation d’Anthropic le dit en toutes lettres : rien ne garantit qu’une règle écrite sera suivie. Pour bloquer une action quoi que Claude décide, il faut un hook, par exemple un PreToolUse, qui s’exécute comme une commande shell à un moment fixe. Le fichier sert à orienter l’agent ; le hook sert à l’empêcher.
La façon d’écrire compte donc. Une consigne vérifiable est suivie plus sûrement : « lancer npm test avant chaque commit » est contrôlable, « tester ses modifications » ne l’est pas.
CLAUDE.md : un fichier vivant, pas une fiche statique
Retour d’expérience : la dérive et le vieillissement du fichier CLAUDE.md
Le CLAUDE.md de mon vault Obsidian fait aujourd’hui 296 lignes, soit 22 023 octets (mesure du 5 octobre 2026). La documentation d’Anthropic vise moins de 200 lignes par fichier, car un fichier plus long consomme du contexte et réduit l’adhérence. Je suis donc au-dessus de la cible, et je préfère le dire. Il s’agit d’une cible de qualité, pas d’une limite technique : Claude Code charge un CLAUDE.md jusqu’à 4 Mio en entier. Le seuil strict de 200 lignes ou 25 Ko ne s’applique qu’à MEMORY.md.
Le 4 juillet 2026, j’ai audité ma configuration en lecture seule, chiffres validés avec /context : environ 25 000 tokens de configuration étaient chargés avant même mon premier message. Le CLAUDE.md listait 13 skills alors que 29 existaient réellement : la liste avait dérivé. Je l’ai remplacée par un renvoi vers la commande /skills, et le fichier est passé de 19 992 à 18 256 caractères.
Trois mois plus tard, il a regrossi. La comparaison est approximative (des octets aujourd’hui, des caractères en juillet, et le français accentué pèse un peu plus en octets), mais la tendance est nette : un dégraissage ponctuel ne fixe pas la taille.
Autour du fichier, la mémoire du projet compte maintenant 252 fichiers, dont 155 de type « feedback » : des corrections et des façons de travailler que l’agent a accumulées, dans le dossier mémoire de Claude Code pour ce vault.
Les erreurs récurrentes et leur capitalisation dans CLAUDE.md
Plusieurs de mes règles sont nées d’un incident précis, et le fichier le dit.
- L’apostrophe courbe : un nom de fichier contenant
’(celle que génère le Web Clipper) ne correspond pas à un chemin tapé avec'. La commande échoue sans indice sur la cause. Règle ajoutée le 5 septembre 2026 : vérifier le nom exact avant d’agir. - Le dollar dans un nom de fichier : entre guillemets doubles,
$30kdevient$3suivi de0k, et le nom est tronqué en silence. Règle : guillemets simples obligatoires. - Les tâches jamais clôturées : le 2 septembre 2026, j’ai imposé de lier chaque élément de la note du jour à sa tâche, faute de quoi la clôture automatique ne la détecte pas et elle reste ouverte indéfiniment.
Cette capitalisation est utile, mais elle a un revers. Ben BK, créateur de contenu sur ces outils, le résume ainsi : une fausse règle mémorisée se répète à la session suivante, et l’agent l’applique sans la remettre en question. L’audit de juillet l’illustre à petite échelle : une note de ma mémoire affirmait que l’éclatement de notes n’avait pas de skill dédié, alors qu’il existait. Et quand deux consignes se contredisent, la documentation précise que Claude peut en choisir une arbitrairement. Il faut donc relire, corriger les contradictions et sortir les règles devenues obsolètes.
Maintenir et auditer sa mémoire écrite : bonnes pratiques
Limiter la taille et structurer le fichier CLAUDE.md
Visez moins de 200 lignes par fichier. Parmi les leviers possibles, deux n’ont pas le même effet :
- Les règles par chemin (dans
.claude/rules/, avec un champpaths) ne se chargent que lorsque Claude travaille sur les fichiers concernés : elles réduisent réellement le contexte. - Les imports (
@fichier) aident à organiser un fichier long, mais le fichier importé est chargé au démarrage : ils ne réduisent pas le coût en contexte.
Pour la structure, groupez les consignes sous des titres Markdown et des puces : Claude suit mieux des sections organisées que des paragraphes denses. Melvynx, créateur de contenu sur ces outils, va plus loin : faire du fichier un index qui renvoie vers le détail, pas une encyclopédie. Naier Saidane, créateur de contenu, conseille de ne pas rédiger le fichier d’un seul jet : on le fait grandir en demandant à Claude d’ajouter chaque règle au moment où elle apparaît.
Réaliser des audits périodiques avec des outils intégrés
Le plus simple est de commencer par mesurer, comme pour mon audit de juillet : /context montre ce qui est chargé avant le premier message. Pour le contenu, Claude Code propose deux contrôles intégrés.
/doctor prompt-auditcherche les consignes écrites pour d’anciens modèles, les références à des fichiers ou des commandes qui n’existent plus, et les fichiers qui se contredisent. Il couvre par défaut les CLAUDE.md, CLAUDE.local.md et AGENTS.md, ainsi que les règles, skills, commandes et sous-agents. Il produit un rapport avec des corrections proposées, et rien ne change tant que vous ne demandez pas de les appliquer (version 2.1.283 ou plus récente)./doctorpropose aussi de raccourcir un CLAUDE.md versionné : il coupe ce que Claude peut déduire du code (arborescences, listes de dépendances, vues d’architecture) et garde les pièges, les raisons et les conventions qui s’écartent des réglages par défaut (version 2.1.206 ou plus récente).
Au-delà des outils, une méthode : Melvynx préconise un audit tous les 3 à 6 mois, avec quatre décisions pour chaque ligne (garder, mettre à jour, fusionner, supprimer). Il cite un agent.md dont 573 lignes ont été supprimées pour 193 conservées. Mon audit de juillet cherchait la même chose : des listes qui avaient dérivé et des règles qui se contredisent. Il m’avait aussi fait déplacer sept entrées de projets terminés vers un fichier d’archive que Claude ne charge pas automatiquement.
Pour la mémoire, Ben BK propose un test simple avant de garder une note : la prochaine tentative sera-t-elle meilleure grâce à elle ? Il conseille de conserver une préférence confirmée, une décision d’architecture avec sa raison, une erreur récurrente avec sa solution, et l’état d’un travail en cours. Une hypothèse non vérifiée ou un détail qui ne sera plus vrai demain n’y a pas sa place.
Compléments : auto memory et auto dream pour la consolidation
L’auto memory est la partie officielle de ce duo : activée par défaut en session locale, elle garde des notes propres à la machine, et Claude y ajoute des entrées au fil de vos corrections. Quand le fichier d’index approche la limite, Claude Code lui demande de le raccourcir.
L’auto dream est un autre sujet. Tessl l’a rapporté en test en mars 2026 : une fonction non officielle, présente dans des versions récentes de Claude Code (2.1.83 et suivantes) d’après des retours de la communauté, qui relirait les fichiers de mémoire, fusionnerait les entrées qui se recoupent et supprimerait les détails périmés. Des développeurs la comparent à la consolidation de la mémoire pendant le sommeil. Je ne l’ai pas retrouvée dans la documentation officielle consultée pour cet article, et son statut actuel n’est pas vérifié. Ce niveau de consolidation n’existe pas dans mon vault pour l’instant.
FAQ
Faut-il un CLAUDE.md global ou un CLAUDE.md par projet ?
Les deux ont leur place. D’après la documentation d’Anthropic, le fichier utilisateur (~/.claude/CLAUDE.md) porte vos préférences personnelles pour tous vos projets, et le fichier du projet porte ce que toute l’équipe doit savoir sur celui-ci. Mettez dans le premier ce qui ne dépend pas du projet, et tout le reste dans le second.
À quelle fréquence faut-il auditer son CLAUDE.md ?
Melvynx, créateur de contenu sur ces outils, recommande un audit tous les 3 à 6 mois (la méthode est détaillée plus haut). Le mien a regrossi en trois mois après le dégraissage de juillet, ce qui plaide pour la fourchette basse. Entre deux audits, l’avertissement affiché au démarrage signale un fichier trop long.
CLAUDE.md ou auto memory : lequel choisir ?
Ils n’ont pas le même auteur. Le CLAUDE.md contient les règles que vous écrivez et relisez vous-même ; l’auto memory contient les notes que Claude prend à partir de vos corrections. J’utilise les deux : le fichier pour les règles stables, la mémoire pour les corrections accumulées (252 fichiers dans le dossier mémoire de Claude Code pour mon vault). Plus cette seconde couche grossit, plus elle demande d’entretien.
Conclusion : une mémoire écrite à entretenir comme un jardin
Un CLAUDE.md qu’on remplit une fois puis qu’on oublie devient un jardin en friche : les règles s’y empilent et certaines se contredisent. Le tailler demande de viser moins de 200 lignes et de lancer régulièrement /doctor prompt-audit.
Mon fichier en est là : 296 lignes, au-dessus de la cible, après un premier dégraissage qui n’a pas tenu.
Pour poursuivre : Claude Code pour le SEO sans coder, le pipeline IA que j’ai construit pour rédiger mon site, ma stack IA de solopreneur et le bilan réel de mes automatisations n8n.
📬 Envie d’aller plus loin ?
Je partage chaque weekend des conseils concrets pour créer, optimiser et monétiser ta présence en ligne (plateformes, SEO, copywriting…).
Pas de spam. Pas de blabla.
Juste une newsletter utile, écrite à la main par un freelance qui vit de ses contenus.
🎁 En bonus à l’inscription :
➡️ Un audit SEO ou appel stratégique offert (pour abonnés uniquement)